Los Agentes actuales ya pueden llamar herramientas, modificar archivos y ejecutar pruebas con soltura, pero cuando se enfrentan a un gran sistema de software que ha evolucionado durante mucho tiempo, ¿pueden partir de un nuevo requisito y entregar una funcionalidad completa?
Cuando un gerente de producto propone un nuevo requisito, lo que los desarrolladores reciben a menudo no es una lista de archivos ni firmas de funciones. Primero necesitan comprender las restricciones, rastrear las dependencias entre módulos y luego determinar dónde cambiar, cómo cambiar y cómo demostrar que los cambios son correctos. Estos análisis afectan la entrega posterior.
La Universidad de Fudan, la Universidad de la Ciudad de Hong Kong, la Universidad China de Hong Kong y otras instituciones proponen LoLBench, que coloca a los Agentes en sistemas de software con un promedio de aproximadamente 2,4 millones de líneas de código fuente, evalúa el proceso completo desde la propuesta de una funcionalidad hasta la entrega del módulo, y pone a prueba la capacidad de percepción para fundamentar los requisitos en el sistema, así como la capacidad de implementación para completar modificaciones entre módulos.
Enlace al artículo: https://arxiv.org/abs/2609.37143
Conjunto de datos: https://huggingface.co/datasets/lolbench26/LoLBench
Los experimentos exponen un punto de ruptura clave: un Agente puede realizar un cambio local correcto pero pasar por alto cambios en otros módulos que deben sincronizarse. Incluso con orientación de implementación complementaria, la mayoría de las tareas siguen sin resolverse, y todavía hay una larga distancia desde comprender los requisitos hasta completar la entrega.
Redefinir las tareas de código de horizonte largo
¿Qué tipo de tarea de código de horizonte largo tiene valor de ingeniería real?
El "horizonte largo" no puede juzgarse solo por el tiempo consumido, el número de rondas o el consumo de Tokens. Por ejemplo, pedirle a un Agente que emita un número por minuto, contando del 1 al 1000, lleva mucho tiempo pero solo requiere un bucle simple. Las tareas de corrección de errores locales al estilo SWE-bench tampoco pueden cubrir el desafío desde el análisis de requisitos hasta la entrega del módulo.
Las tareas de código de horizonte largo en las que se centra LoLBench son el desarrollo de módulos para sistemas complejos. Tras recibir un nuevo requisito, los desarrolladores analizan repetidamente: ¿qué comportamientos deben implementarse? ¿Puede la arquitectura existente soportarlos? ¿Qué dependencias se verán afectadas? ¿Cómo verificarlo? LoLBench también incorpora a la evaluación este análisis que permanece oculto en la mente de los desarrolladores, permitiendo que el Agente derive el plan de implementación por sí mismo a partir de la intención del usuario.
Dichas tareas poseen simultáneamente complejidad de percepción y complejidad de implementación: la primera es la dificultad de comprender la propuesta, identificar restricciones implícitas y dependencias entre módulos, y derivar el alcance de la modificación y la especificación de implementación; la segunda es la dificultad de convertir la especificación en modificaciones correctas entre archivos y, mediante pruebas y reparación, evitar que se rompa la funcionalidad existente.
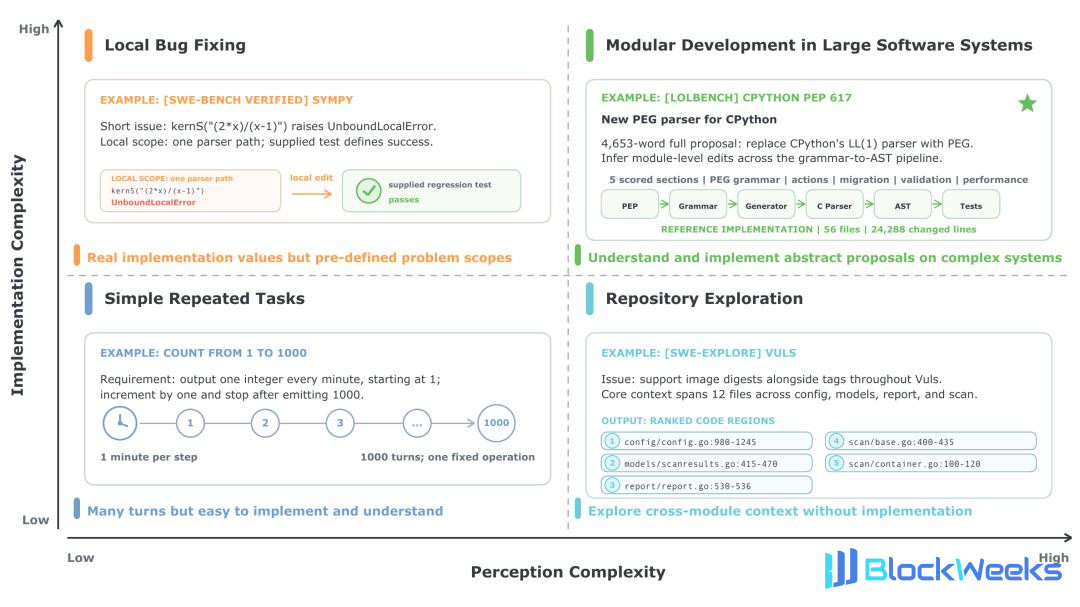
Figura 1 Comparación de la complejidad de percepción y la complejidad de implementación.
Cómo LoLBench evalúa ambos tipos de complejidad simultáneamente
Derivar especificaciones de implementación a partir de propuestas de funcionalidades
LoLBench selecciona 100 tareas de Propuestas de Mejora de la comunidad y sus PR fusionados correspondientes, abarcando 29 sistemas, 8 lenguajes y 5 dominios.
El Agente solo recibe la propuesta y el repositorio de código antes de la implementación; la propuesta tiene un promedio de aproximadamente 5000 palabras en inglés. La evaluación se realiza en un entorno Docker sin conexión para evitar que el Agente recupere implementaciones upstream.
Por ejemplo, PEP 617 [1] propone reemplazar el analizador LL(1) de CPython por PEG, y la implementación requiere conectar definiciones gramaticales, generación de analizadores, árboles de sintaxis abstracta y reporte de errores. El Agente debe identificar toda la cadena de implementación.
En términos de complejidad de percepción, la tasa de mención promedio en la propuesta de los nombres de las clases objetivo en la implementación de referencia de LoLBench es solo del 7,3%, menos de la mitad de SWE-bench Verified (15,9%) y menos de una quinta parte de FeatureBench (38,7%). El Agente debe inferir por sí mismo la conexión entre los requisitos y el código.
Convertir especificaciones en entrega de ingeniería
En términos de complejidad de implementación, los repositorios de LoLBench tienen en promedio alrededor de 2,4 millones de líneas de código fuente, aproximadamente 9,4 veces las de SWE-bench Verified y 4,9 veces las de FeatureBench; las implementaciones modifican en promedio 5.499 líneas, en comparación con 38 líneas y 2.050 líneas de los dos últimos. Cada tarea modifica en promedio 64,9 archivos, 40,1 clases y 195,9 funciones; el número de archivos es 25 veces y 4,2 veces los de los dos, respectivamente. La coordinación y verificación entre módulos son más difíciles.

Tabla 1 Comparación de LoLBench con los conjuntos de evaluación de tareas de código existentes.
LoLBench verifica la corrección de la entrega mediante dos tipos de pruebas: las pruebas de nuevas funcionalidades (F2P) requieren fallar antes de la implementación y pasar después de la implementación; F2P verifica el comportamiento a través de interfaces públicas y permite diferentes implementaciones internas. Las pruebas de regresión (P2P) requieren pasar tanto antes como después.
Sobre la base de las pruebas originales del proyecto, el equipo de investigación construye implementaciones erróneas, como funcionalidades faltantes y requisitos alterados, como mutantes, complementa casos de prueba para identificar errores no detectados y mejora la cobertura de pruebas de los parches de referencia.
Tras la mejora, la tasa de detección de 1.688 mutantes aumenta de aproximadamente el 61% al 96%, y la cobertura de líneas promedio por tarea de F2P aumenta de aproximadamente el 60% al 79%.
Rendimiento y cuellos de botella de 28 combinaciones de Agentes
Cambiando modelos o andamiajes, la tasa de resolución más alta de los Agentes es solo del 14%
El equipo de investigación evalúa 28 combinaciones disponibles de 6 modelos de frontera y 5 andamiajes, con un límite de tiempo de 6 horas por tarea. Opus 5 emparejado con Claude Code o mini-SWE-agent empatan con la tasa de resolución más alta del 14%, y la mediana entre todas las combinaciones es solo del 2%.

Tabla 2 Resultados experimentales principales del artículo
Usando también Opus 5, mini-SWE-agent y Claude Code lograron la misma tasa de resolución, pero el primero tardó 3,2 veces más que el segundo y generó 5 veces más tokens; un mayor consumo no trajo una tasa de resolución más alta.
Una gran cantidad de interacción y tokens se dedica a la localización de código
En términos de consumo de tokens, promediado entre agentes, la etapa de localización representó el 52,4% de los tokens de entrada no almacenados en caché y el 45,4% de los tokens generados. En términos del número de rondas de interacción del agente, la etapa de localización también tuvo significativamente más rondas de interacción que otras etapas.

Figura 2 Número promedio de rondas de interacción en cada etapa.
Para los archivos y funciones existentes modificados con respecto a la implementación de referencia, en los 28 grupos de agentes, la precisión de modificación de archivos osciló entre el 38,0% y el 80,4%, y la exhaustividad entre el 30,3% y el 65,0%; la precisión de modificación de funciones osciló entre el 54,2% y el 65,6%, y la exhaustividad entre el 20,8% y el 53,4%. La precisión de localización del código es baja y la cobertura sigue siendo incompleta.
Incluso después de complementar la guía de modificación, los agentes siguen teniendo dificultades para entregar completamente
El equipo de investigación mantuvo la propuesta de funcionalidad original y además proporcionó un árbol de archivos de modificación exportado de la implementación de referencia y especificaciones de implementación de API para ayudar a los agentes a determinar el alcance de las modificaciones. La tasa de resolución de Opus 5+Claude Code aumentó del 14% al 34%, GPT-5.6 Sol+Codex pasó del 3% al 25%,
DeepSeek
V4 Flash+OpenCode pasó del 1% al 17%.

Tabla 3 Resultados experimentales tras complementar el árbol de archivos de modificación y las especificaciones de implementación de API
Complementar la guía de modificación puede aliviar la carga de percepción, pero la mejor combinación aún tenía el 66% de las tareas sin resolver. Los agentes todavía necesitan coordinar módulos, implementar interfaces y pasar la validación, lo que sugiere que la complejidad de implementación de sistemas grandes también es muy alta.
De la generación de código hacia la evolución de grandes sistemas de software
Estos resultados proporcionan direcciones verificables para la investigación y el desarrollo de agentes: si la recuperación en el repositorio puede cubrir las dependencias clave, si las especificaciones de implementación antes de la codificación están completas y si la validación puede detectar oportunamente omisiones entre módulos.
El valor de la ingeniería de software radica en si los requisitos del usuario pueden cumplirse de manera fiable. Los agentes necesitan comprender por qué ocurren los cambios, cómo afectan al sistema e implementar plenamente los cambios. LoLBench espera promover la evaluación de las capacidades de los agentes desde la generación de código hacia el apoyo a la evolución continua del software, haciendo de los resultados de entrega la vara de medir para poner a prueba las capacidades de los agentes.
Referencia: PEP 617: https://peps.python.org/pep-0617/
Este artículo proviene de la cuenta pública de WeChat "Xinzhiyuan", autor: Xinzhiyuan; editor: LRST