Кратко
- Топовые модели Anthropic и OpenAI стоят в 100 раз дороже за токен, чем их самые маленькие модели, но многие пользователи по умолчанию используют флагманскую модель для всего.
- Таблицы лидеров по использованию в Meta, Amazon и Uber подняли счета за ИИ, и Uber израсходовал свой бюджет на ИИ-инструменты на 2026 год примерно за четыре месяца.
- Маршрутизация задач к подходящей модели, сокращение контекста, кэширование и пакетная обработка резко снижают затраты, но есть и другие методы экономии денег.
Сотрудники Meta израсходовали 60 триллионов ИИ-токенов за 30 дней в начале этого года, гонясь за местами во внутренней таблице лидеров, которую прозвали «Claudeonomics». Технический обозреватель Гергели Орос оценил счет примерно в 900 миллионов долларов по прайс-листу Anthropic, хотя Meta, вероятно, платит гораздо меньше.
Консультант Bain & Company Цзюэ Ван повсюду видит более тихую версию этого расточительства: «Столько компаний, столько пользователей по умолчанию используют Opus для всего, включая создание электронных писем», — рассказала она Associated Press этим летом, имея в виду высококлассные модели Anthropic. Если вы делаете то же самое, вы нанимаете Альберта Эйнштейна, чтобы посчитать сдачу в McDonald's.
Каждое слово, которое вы вводите в ChatGPT или Claude, и каждое слово, которое они пишут в ответ, измеряется в токенах — фрагментах текста, в среднем составляющих около трёх четвертей слова. При подписке за $20 этот счётчик определяет, как быстро вы достигнете лимита использования. В API — доступе с оплатой за токен, который разработчики используют для подключения моделей к своим приложениям, — он определяет счёт.
Вот текущий прайс-лист Anthropic, за миллион токенов:
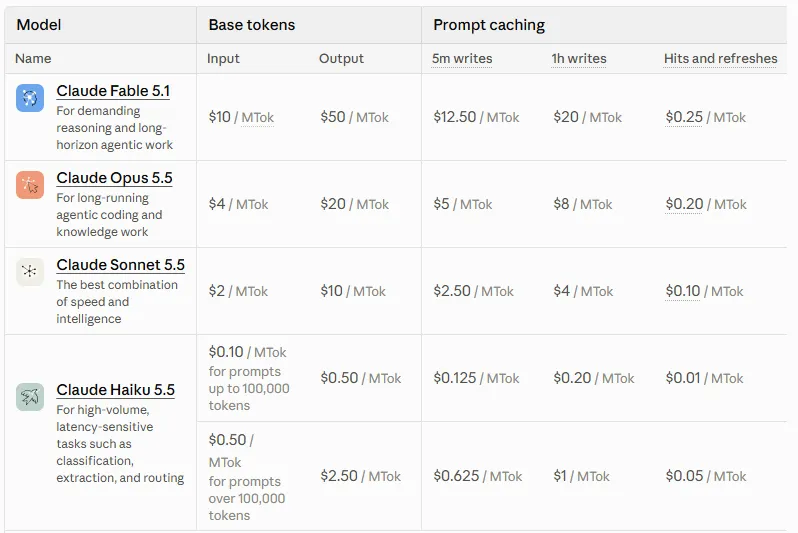
Тариф Haiku применяется к запросам объёмом менее 100 000 токенов; более длинные запросы стоят в пять раз дороже.
Самая топовая модель стоит в 100 раз дороже самой маленькой, и собственная линейка OpenAI демонстрирует такой же разброс — от $10 до $0,10 за миллион входных токенов. Эти цены за токен быстро накапливаются для лабораторий — и для вас: выручка Anthropic в годовом исчислении выросла примерно с $9 млрд в конце 2025 года до более чем $47 млрд к маю, в то время как OpenAI ведёт ценовую войну, чтобы не отставать.
Несколько привычек резко сокращают эти расходы, и первые пять советов ниже не требуют никакого программирования.
Что означает tokenmaxxing (и что оно должно означать)
Tokenmaxxing начался как кремниевовская показуха вроде Meta Claudeonomics, когда Microsoft, Shopify и Amazon ранжировали сотрудников по аналогичным таблицам лидеров по токенам. Генеральный директор Nvidia Дженсен Хуанг подлил масла в огонь, когда в марте в подкасте «All-In» заявил, что был бы «глубоко встревожен», если бы инженер с зарплатой $500 000 не сжигал токенов как минимум на $250 000.
И они жгли токены… на глупые непродуктивные вещи.
В Amazon сотрудники признались в завышении своих показателей, запуская внутренний ИИ-инструмент для нерелевантных задач, пока старший вице-президент не сказал сотрудникам: «Пожалуйста, не используйте ИИ только ради того, чтобы использовать ИИ».
В этом руководстве используется значение, которое инженеры продвигают сейчас: максимизация ценности каждого токена, а не количества, которое вы тратите.
Три концепции объясняют, куда уходят токены, начиная с цикла агента. Агент — это модель, которая может использовать инструменты, поэтому она думает, ищет в интернете или выполняет код, читает результат и повторяет, пока не решит, что закончила, отправляя весь разговор заново на каждом круге.
Оркестрация умножает эту стоимость: одна модель выступает в роли менеджера, разбивая ваш запрос на части, передавая их рабочим моделям, называемым субагентами, и сшивая их ответы обратно вместе. Каждый работник запускает свой собственный цикл со своей собственной памятью, поэтому Anthropic говорит, что команды агентов в Claude Code могут использовать примерно в семь раз больше токенов, чем стандартная сессия, когда товарищи по команде работают в режиме планирования — настройке, описанной в промежуточных советах ниже.
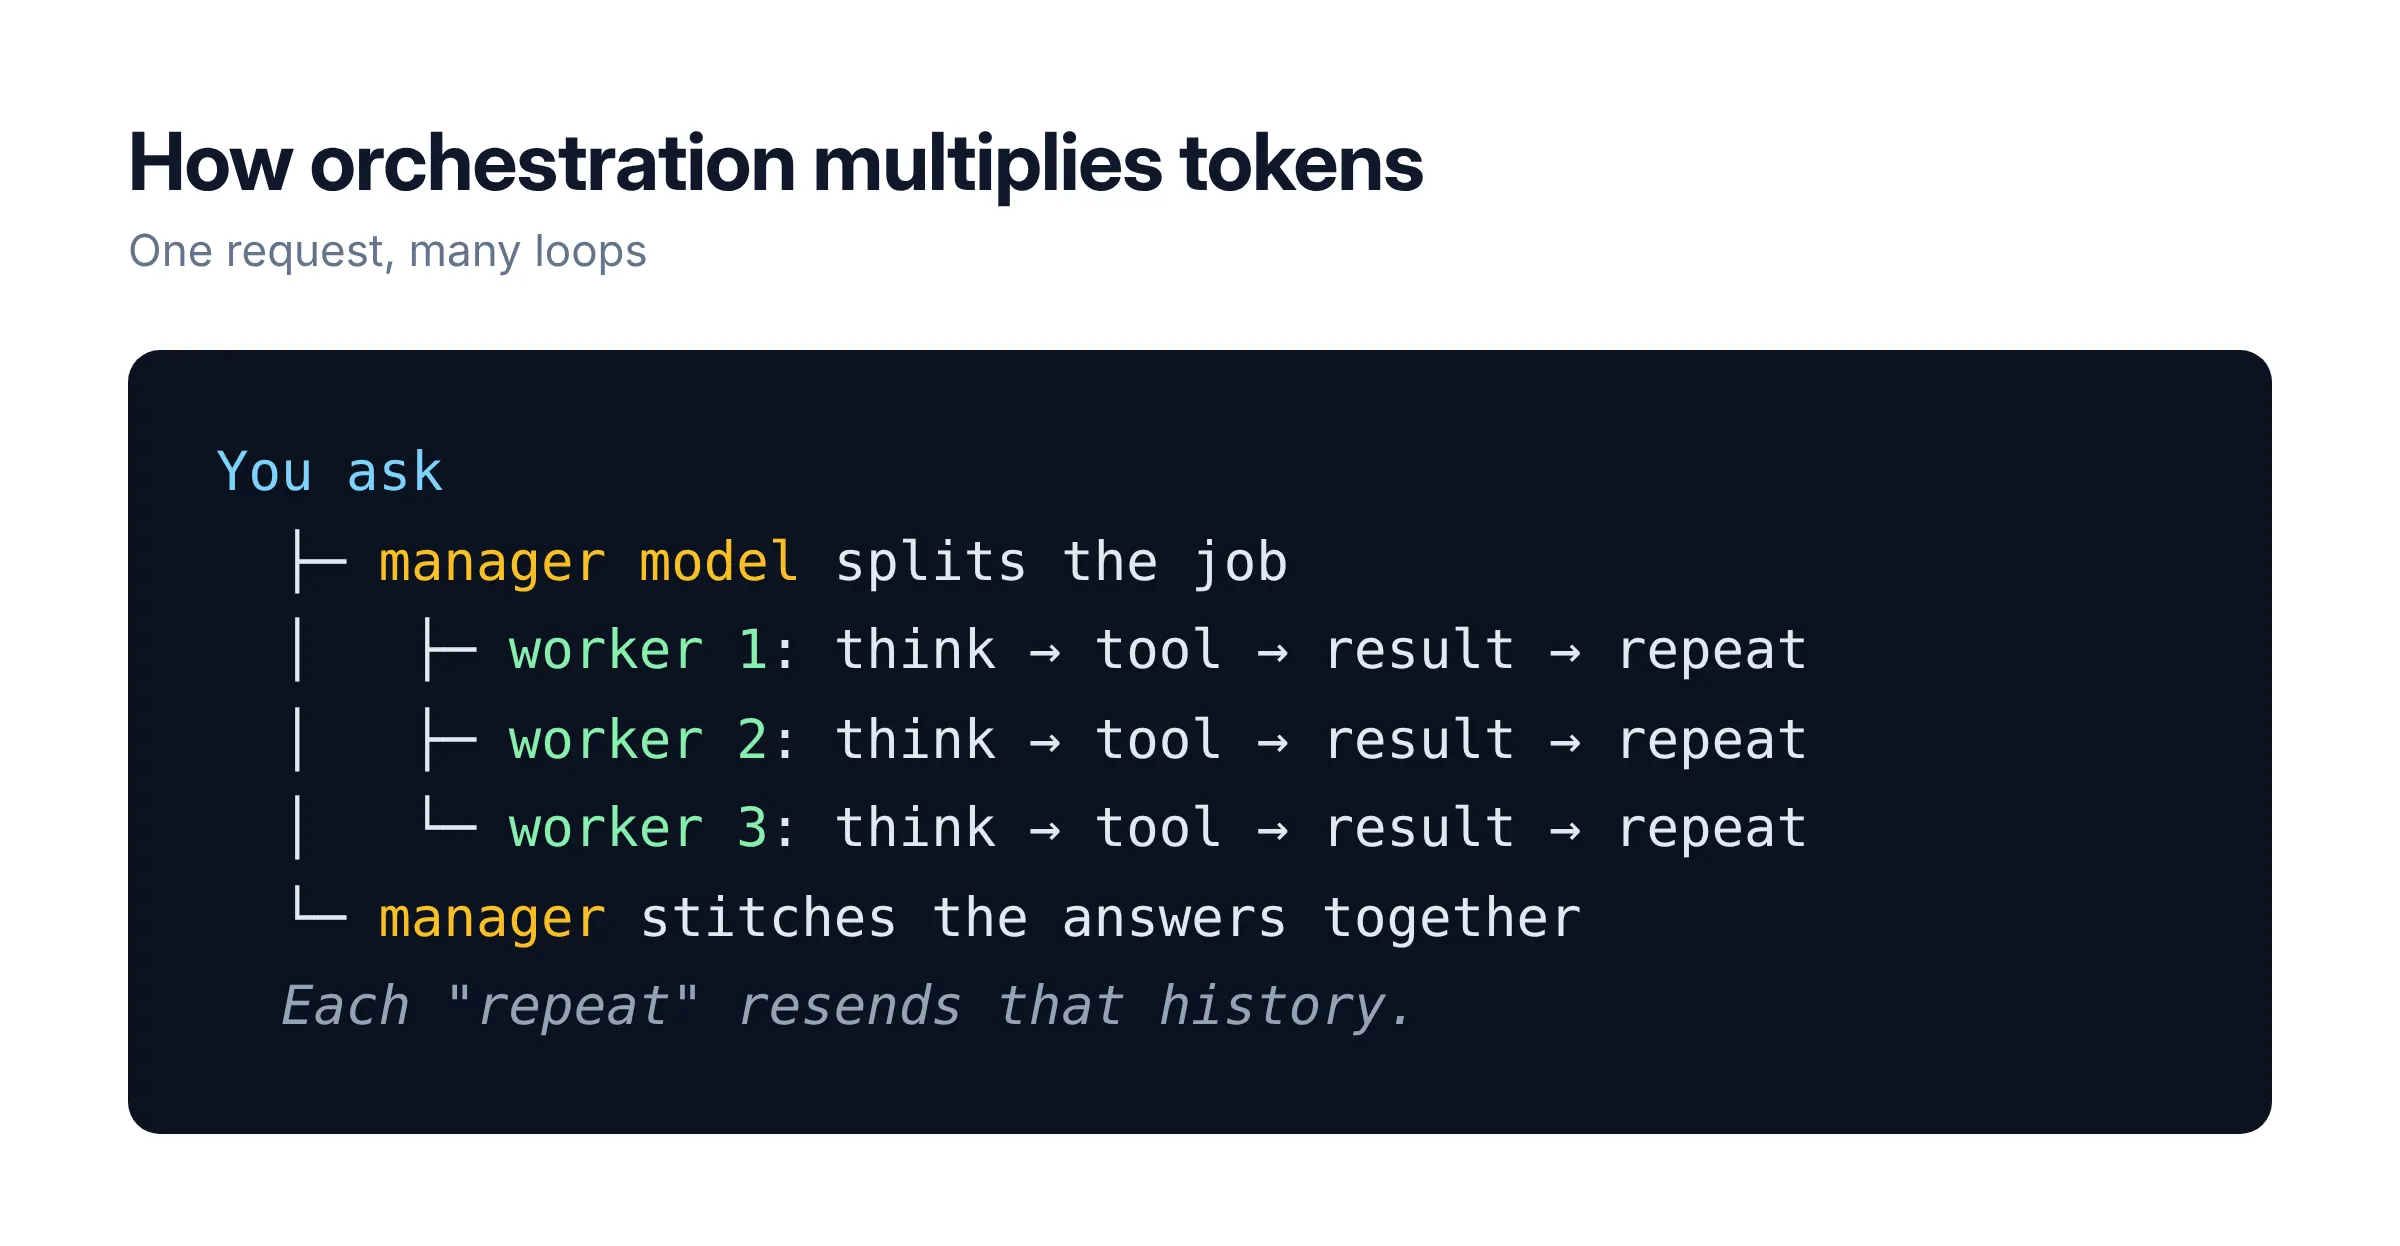
Графы — это то, как разработчики не дают этим циклам сбиться с пути. Такие фреймворки, как LangGraph, позволяют нарисовать рабочий процесс как схему метро, где станции (узлы) выполняют работу, а пути (рёбра) решают, куда двигаться дальше, так что модель следует фиксированному маршруту, а не зацикливается, пока не исчерпает идеи или бюджет.
Иными словами, циклы помогают автоматизировать задачи и повысить качество, но вы также потратите много денег, поэтому крайне важно быть эффективным. Вот несколько советов, которые могут вам в этом помочь
Для начинающих: небольшие задачи, небольшие модели
1. Выберите модель под задачу
Если вы только начинаете, вы, скорее всего, используете графический интерфейс для запуска своего ИИ.
Нажмите на название модели в вашем чат-приложении (в верхней части чата в ChatGPT, рядом с кнопкой отправки в Claude или Hermes) и переключитесь на меньший, более быстрый вариант для писем, резюме и перефразирования. Оставьте топовую модель для сложных рассуждений и решений, где тонкая ошибка стоит реальных денег.
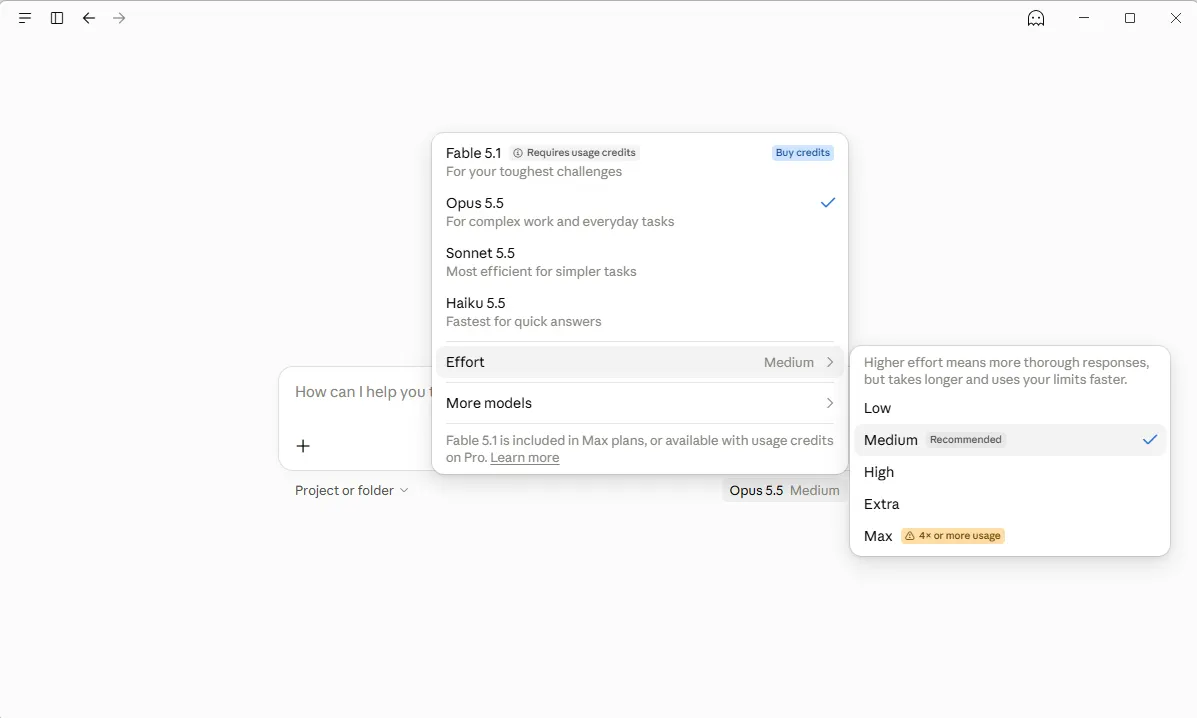
Запустите пять задач с прошлой недели на обеих моделях параллельно, и если меньшая справляется, оставьте её. На подписке это продлит ваш лимит использования, а на API сократит счёт до 99%.
2. Напишите один хороший промпт вместо пяти плохих
Три раунда «нет, только итог» или «сделай это лучше и точнее» каждый раз отправляют весь чат заново. Один чёткий промпт излагает задачу и точную форму ответа. Что-то вроде этого может сработать:
Извлеките номер счёта, дату, поставщика и итоговую сумму из текста ниже. Сохраняйте каждое значение точно как написано. Возвращайте по одной строке на поле и пишите «отсутствует», если поле отсутствует.
Собственное тестирование OpenAI показало, что более лаконичные и ясные промпты получали более высокие оценки, используя при этом меньше токенов.
3. Начинайте новый чат при смене темы
Модель перечитывает всю переписку каждый раз, когда вы нажимаете «отправить», поэтому ветка из 50 сообщений о вашем отпуске делает ваш налоговый вопрос одновременно дороже и глупее.
Anthropic называет это ухудшение «гниением контекста».
Так что, ради всего святого, начинайте новый чат всякий раз, когда меняется тема.
4. Просите нужный вам объём
Выходные токены стоят в пять раз дороже входных в топовых моделях Anthropic и OpenAI. Завершайте свои промпты чем-то вроде «три пункта, менее 100 слов» или «только изменённые строки», и у модели останется меньше пространства для воды.
Если у модели есть ограничение по длине вывода, она будет экономить токены, особенно если задача творческая (например, написание текстов или исследование), а не детерминированная (например, программирование или решение математических задач).
5. Попробуйте бесплатно, прежде чем платить
OpenRouter — сайт, который подключается к сотням ИИ-моделей через один аккаунт, — имеет бесплатный роутер, который отправляет ваш запрос одной из примерно 20 бесплатных моделей. Вы также можете запускать модели локально с помощью LM Studio или Ollama на видеокарте с 8 ГБ видеопамяти или на Mac с чипом Apple серии M.
Бесплатные тарифы могут исчезнуть за одну ночь, поэтому не стройте на них ничего важного и прочитайте политику обработки данных, прежде чем вставлять что-либо конфиденциальное.
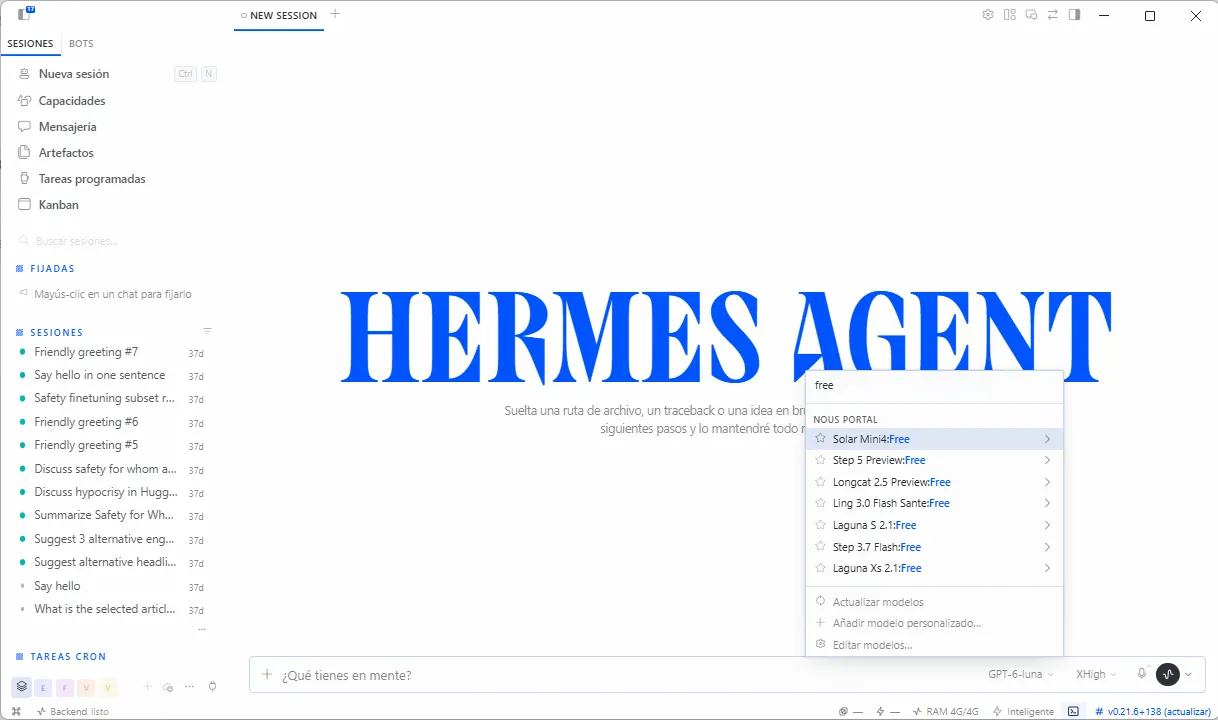
Тем не менее, вы можете максимизировать количество итераций, используя бесплатные предложения. У Hermes есть хороший выбор бесплатных моделей, которые могут справиться с нужной вам задачей, как и у Nvidia. Лучше настраивать промпт с помощью бесплатной, более глупой модели, чем платить за премиальную модель, которая сделает то же самое, но быстрее.
Дополнительные советы для начинающих
Пропускайте расширенное мышление для простых вопросов или снижайте уровень усилий в новых моделях Claude, где мышление нельзя отключить. Anthropic оплачивает весь процесс мышления как выходные данные, включая ту часть, которую вы никогда не видите.
Подписчики Claude Pro и Max, которые включают кредиты на использование, могут установить месячный лимит расходов в разделе «Настройки», затем «Использование».
Средний уровень: ваш агент читает слишком много
Далее в примерах используется Claude Code — агент Anthropic, который работает в вашем терминале и редактирует файлы за вас; команды вводятся прямо в его чат. В других оболочках будет похожая логика.
Если вы пользуетесь только чат-приложениями, совет 8 также работает в любом окне чата.
6. Начинайте с дешёвого, повышайте при неудаче
Введите /model, чтобы переключать модели, оставляйте Sonnet по умолчанию и переходите на Opus только тогда, когда Sonnet не справляется с чем-то конкретным, например с ошибкой, которую не может исправить после двух попыток. Для простых задач субагентов документация Anthropic предлагает устанавливать model: haiku в настройках субагента.
7. Очищайте между задачами
Введите /clear, когда переключаетесь на несвязанную задачу, это ничего не стоит и сбрасывает старую историю. Используйте /compact с пометкой о том, что сохранить, например /compact keep the database decisions, только когда вам нужна история, поскольку компактирование само по себе является большим запросом.
8. Пусть код делает скучную математику
Вставка таблицы на 5 000 строк в чат заставляет модель читать каждую строку, и она всё равно может ошибиться в подсчёте, потому что языковая модель не калькулятор, сколько бы вы за неё ни платили.
Вместо этого попросите у неё формулу или короткий скрипт, запустите его сами и передайте модели только результат.
9. Сократите свои инструменты
MCP-серверы — это плагины, которые подключают модель к приложениям вроде GitHub или Google Drive, и каждый из них добавляет имена инструментов и инструкции в каждую сессию.
Введите /context, чтобы увидеть, что занимает место, и /mcp, чтобы отключить серверы, которые проект не использует.
Дополнительные промежуточные советы
Введите /usage, чтобы увидеть, куда ушли ваши токены. Держите ваш CLAUDE.md (или Soul.md), файл инструкций, который ваш агент читает в начале каждой сессии, короче 200 строк.
Для более крупных изменений нажмите Shift+Tab, чтобы переключиться в режим планирования, где агент предлагает план на ваше утверждение, прежде чем трогать файлы, и нажмите Esc в тот момент, когда он пойдёт не туда. Используйте /effort, чтобы снизить уровень рассуждений для простых задач вроде переименования переменной.
Anthropic показала, что использование токенов агентом упало с 150 000 токенов до 2 000, когда он загружал только те определения инструментов, которые ему были нужны, поэтому инструменты командной строки вроде GitHub gh, которые ничего не стоят, пока не запущены, часто превосходят постоянно включённый плагин.
Продвинутый уровень: встройте ограничения в систему
Возьмём разработчика, которому нужно обработать 1 000 счетов по 2 000 токенов каждый, с ответами по 200 токенов: эта работа стоит около $30 на Fable 5.1 и около $0.30 на Haiku 5.5, ещё до применения любых приёмов, описанных ниже.
10. Кэшируйте части, которые никогда не меняются
Сначала разместите стабильные инструкции, а изменяющиеся части — в конце, и отметьте стабильный блок для кэширования. В API Anthropic это одно дополнительное поле:
"system": [{
"type": "text",
"text": "Ваши инструкции по счетам-фактурам...",
"cache_control": {"type": "ephemeral"}
}]
Чтение из кэша стоит долю обычной цены ввода, а запись в кэш по умолчанию на пять минут стоит дополнительно. Проверяйте поле cache_read_input_tokens в каждом ответе; если после первого вызова оно всё ещё равно нулю, кэш не работает.
11. Отправляйте в пакетную обработку всё, что может подождать
И OpenAI, и Anthropic обрабатывают пакетные задания со скидкой 50%, причём OpenAI обещает результаты в течение 24 часов. Загрузите 1000 счетов-фактур одним пакетным файлом вместо 1000 живых вызовов, и счёт резко уменьшится.
12. Держите агентов на поводке
Установите максимальное число шагов и денежный лимит для каждого запуска агента, и определите, как выглядит «готово», прежде чем он начнётся. Claude Code принимает флаг --max-budget-usd для скриптовых запусков, а Shopify использует автоматические выключатели, которые могут немедленно отрезать доступ разработчика, если его расходы резко возрастут в течение дня, — они созданы, чтобы ловить вышедших из-под контроля агентов.
Прямо сейчас обычное дело — фактически отпустить этих агентов на свободу и заставить их зацикливаться, пока результат не будет признан идеальным. Если у вас нет денег, не позволяйте своим агентам самим решать, что является или не является «идеальным».
Дополнительные продвинутые советы
Помещайте критически важные факты в начало или конец длинного промпта. Исследование под руководством Стэнфорда показало, что модели лучше всего используют информацию в этих позициях и хуже всего, когда она погребена в середине.
Платите за вторую модель для проверки работы только тогда, когда ошибка дорого обходится, например, пункт договора или сумма платежа. В API OpenAI включите жёсткий лимит расходов для каждого проекта, поскольку его оповещения о расходах только уведомляют вас и не останавливают трафик.
Начните с одного теста
Сделайте самую дешёвую модель, которая проходит ваш тест из пяти задач из совета 1, моделью по умолчанию на неделю и переключайтесь только тогда, когда она даёт сбой. Затем сравните страницу вашего использования с показателями предыдущей недели; в задаче с выставлением счетов только маршрутизация сократила счёт с $30 до $3,90, даже после оплаты Opus 5.5 за повторное выполнение 300 неудачных задач.
Однако более дешёвые токены не справятся с задачей в одиночку: цена одного токена упала более чем на 90% с 2023 года, согласно Индексу расходов на токены Silicon Data, но расходы на большие языковые модели удвоились с конца 2025 года.
Экономисты называют это парадоксом Джевонса, когда ресурс становится настолько дешёвым, что люди в итоге тратят на него в общей сложности больше. Краткий отчёт Bain & Co. за июнь выявил ту же закономерность: стоимость токенов снизилась вдвое в период с декабря 2024 по 2025 год, а количество потребляемых токенов выросло на 450%.
Положительная сторона в том, что то же самое падение цен работает на вас, как только вы перестаёте жечь токены ради забавы: сочетайте их с привычками, описанными выше, и ИИ становится дешевле и лучше одновременно.