Kurz gesagt
- Die Top-Modelle von Anthropic und OpenAI kosten pro Token 100-mal mehr als ihre kleinsten Modelle, doch viele Nutzer greifen standardmäßig für alles zum Flaggschiff.
- Nutzungs-Ranglisten bei Meta, Amazon und Uber trieben die KI-Rechnungen in die Höhe, und Uber verbrauchte sein KI-Tools-Budget für 2026 in etwa vier Monaten.
- Aufgaben an das richtige Modell weiterzuleiten, den Kontext zu kürzen, Caching und Batching senkten die Kosten stark, aber es gibt noch andere Techniken, um Geld zu sparen.
Meta-Mitarbeiter verbrauchten Anfang dieses Jahres innerhalb von 30 Tagen 60 Billionen KI-Token, um sich Plätze auf einer internen Rangliste zu sichern, die scherzhaft „Claudeonomics“ genannt wird. Der Tech-Kolumnist Gergely Orosz schätzte die Rechnung auf rund 900 Millionen Dollar zu Anthropics Listenpreisen, wobei Meta wahrscheinlich weit weniger zahlt.
Die Bain-&-Company-Beraterin Jue Wang sieht eine stillere Version dieser Verschwendung überall: „So viele Unternehmen, so viele Nutzer greifen standardmäßig für alles auf Opus zurück, einschließlich der Erstellung von E-Mails“, sagte sie diesen Sommer der Associated Press mit Bezug auf Anthropics High-End-Modelle. Wenn Sie dasselbe tun, heuern Sie Albert Einstein an, um Ihr Wechselgeld bei McDonald’s auszurechnen.
Jedes Wort, das Sie in ChatGPT oder Claude eingeben, und jedes Wort, das es zurückschreibt, wird in Tokens abgerechnet, Textblöcken, die im Durchschnitt etwa drei Viertel eines Wortes entsprechen. Bei einem 20-Dollar-Abonnement entscheidet dieser Zähler darüber, wie schnell Sie Ihr Nutzungslimit erreichen. Bei der API, dem zugangsberechtigten Zugang, den Entwickler nutzen, um Modelle in ihre eigenen Apps einzubinden, entscheidet er über die Rechnung.
Hier ist die aktuelle Preisliste von Anthropic, pro Million Tokens:
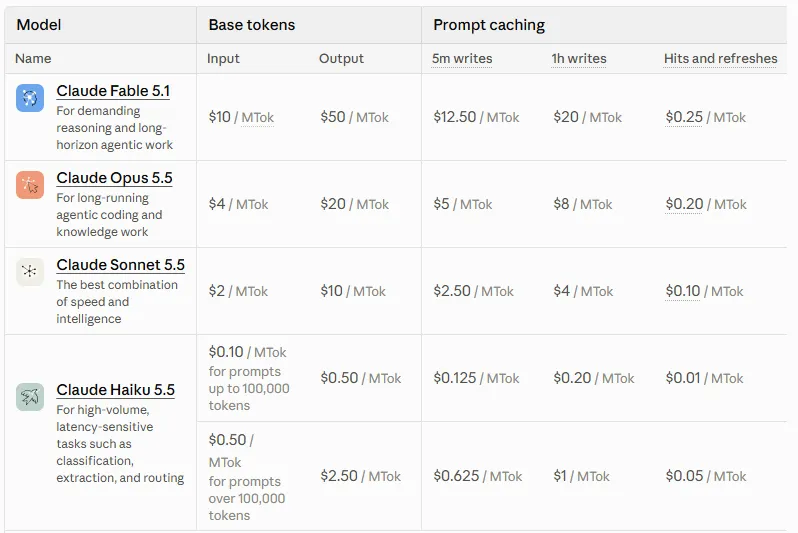
Haikus Tarif gilt für Prompts unter 100.000 Tokens; längere Prompts kosten fünfmal so viel.
Das Topmodell kostet 100-mal mehr als das kleinste, und OpenAIs eigene Produktpalette weist dieselbe Spanne auf, von 10 bis 0,10 US-Dollar pro Million Eingabe-Tokens. Diese Preise pro Token summieren sich schnell für die Labore – und für Sie: Anthropics Umsatzlaufrate stieg von etwa 9 Milliarden US-Dollar Ende 2025 auf mehr als 47 Milliarden US-Dollar bis Mai, während OpenAI einen Preiskampf führt, um mitzuhalten.
Ein paar Gewohnheiten senken diese Ausgaben drastisch, und die ersten fünf Tipps unten erfordern keinerlei Programmierung.
Was Tokenmaxxing bedeutet (und was es bedeuten sollte)
Tokenmaxxing begann als eine Art Silicon-Valley-Prahlen wie Metas Claudeonomics, wobei Microsoft, Shopify und Amazon Mitarbeiter auf ähnlichen Token-Ranglisten bewerteten. Nvidia-CEO Jensen Huang goss Öl ins Feuer, als er im März im Podcast „All-In“ sagte, er wäre „zutiefst alarmiert“, wenn ein 500.000-US-Dollar-Ingenieur nicht mindestens 250.000 US-Dollar an Tokens verbrauchen würde.
Und sie verbrannten Tokens … für dummes, unproduktives Zeug.
Bei Amazon gaben Mitarbeiter zu, ihre Zahlen aufgebläht zu haben, indem sie das interne KI-Tool für irrelevante Aufgaben einsetzten, bis ein Senior Vice President den Mitarbeitern sagte: „Bitte verwendet KI nicht nur um der KI willen.“
Dieser Leitfaden verwendet die Bedeutung, die Ingenieure derzeit vorantreiben: den Wert jedes Tokens zu maximieren, nicht die Anzahl, die man ausgibt.
Drei Konzepte erklären, wohin die Tokens fließen, beginnend mit der Agentenschleife. Ein Agent ist ein Modell, das Werkzeuge verwenden kann, also denkt es, durchsucht das Web oder führt Code aus, liest das Ergebnis und macht weiter, bis es entscheidet, dass es fertig ist, wobei es bei jeder Runde die gesamte Konversation erneut sendet.
Orchestrierung vervielfacht diese Kosten: Ein Modell fungiert als Manager, teilt Ihre Anfrage in Teile auf, übergibt sie an Arbeitermodelle, sogenannte Subagenten, und fügt deren Antworten wieder zusammen. Jeder Arbeiter führt seine eigene Schleife mit seinem eigenen Gedächtnis aus, weshalb Anthropic sagt, dass Agententeams in Claude Code etwa siebenmal mehr Tokens als eine Standardsitzung verbrauchen können, wenn Teammitglieder im Planmodus laufen, einer Einstellung, die in den untenstehenden fortgeschrittenen Tipps behandelt wird.
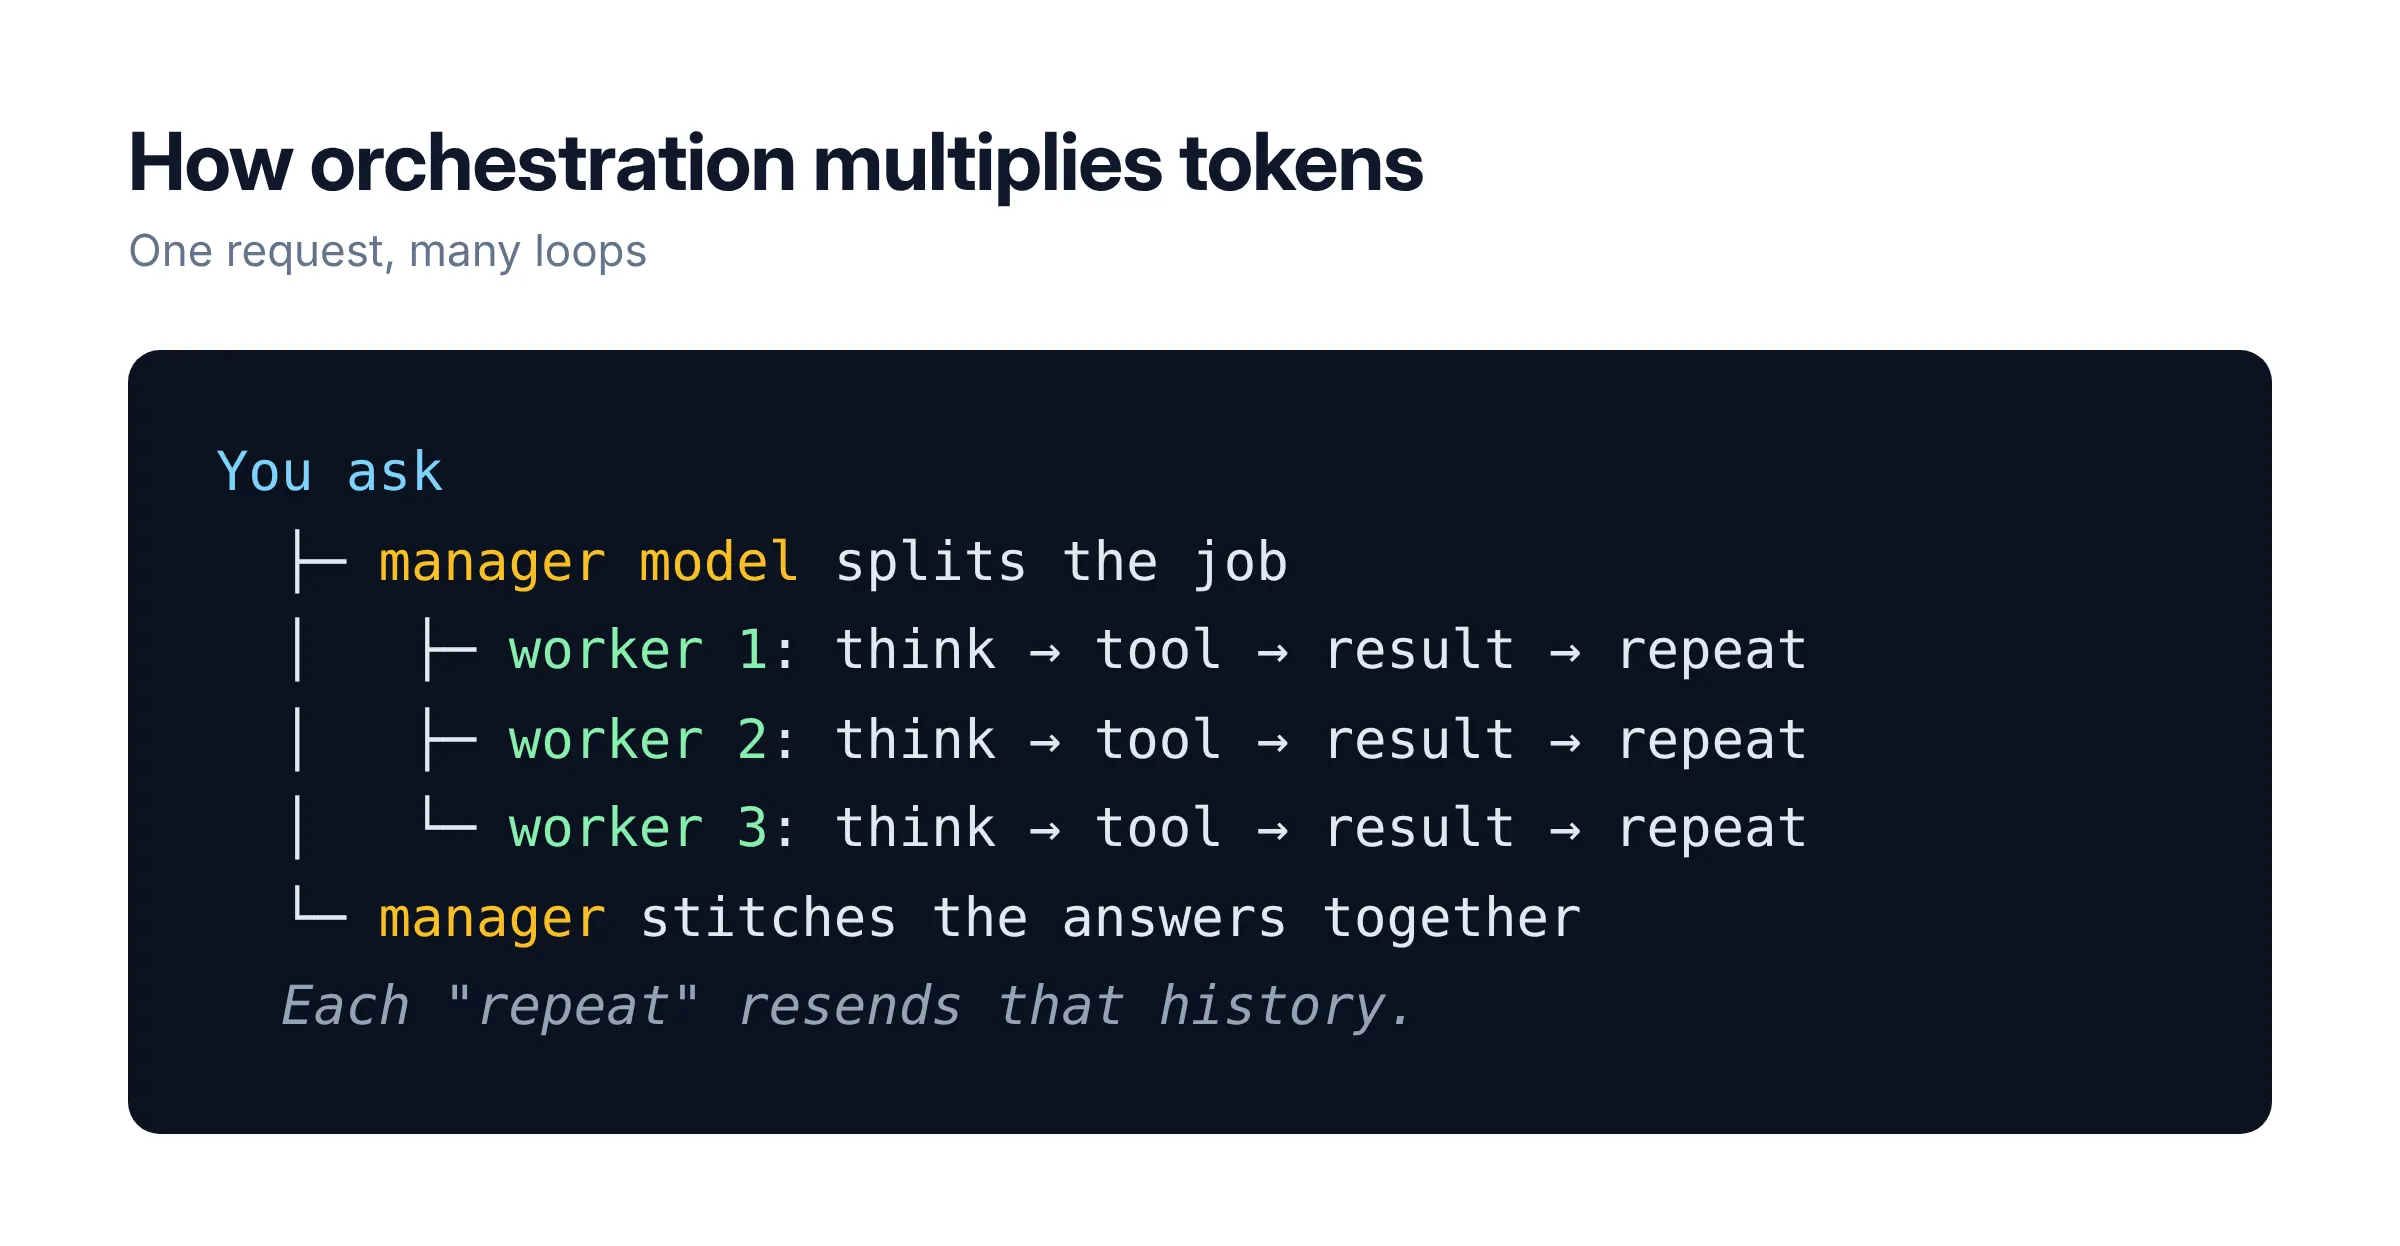
Graphen sind die Art und Weise, wie Entwickler verhindern, dass diese Schleifen abschweifen. Frameworks wie LangGraph ermöglichen es Ihnen, einen Workflow wie eine U-Bahn-Karte zu zeichnen, mit Stationen (Knoten), die die Arbeit erledigen, und Gleisen (Kanten), die entscheiden, wohin es als Nächstes geht, sodass das Modell einer festen Route folgt, anstatt zu schleifen, bis ihm die Ideen oder das Budget ausgehen.
Mit anderen Worten: Schleifen helfen Ihnen, Dinge zu automatisieren und die Qualität zu steigern, aber Sie werden auch viel Geld ausgeben, daher ist es äußerst wichtig, effizient zu sein. Hier sind einige Tipps, die Ihnen dabei helfen können
Für Anfänger: kleine Aufgaben, kleine Modelle
1. Wähle das Modell passend zur Aufgabe
Wenn du gerade erst anfängst, verwendest du wahrscheinlich eine grafische Benutzeroberfläche, um deine KI auszuführen.
Klicke in deiner Chat-App auf den Modellnamen (oben im Chat bei ChatGPT, neben der Senden-Schaltfläche bei Claude oder Hermes) und wechsle für E-Mails, Zusammenfassungen und Umformulierungen zu einer kleineren, schnelleren Option. Behalte das Top-Modell für schwieriges Schlussfolgern und Entscheidungen, bei denen ein subtiler Fehler echtes Geld kostet.
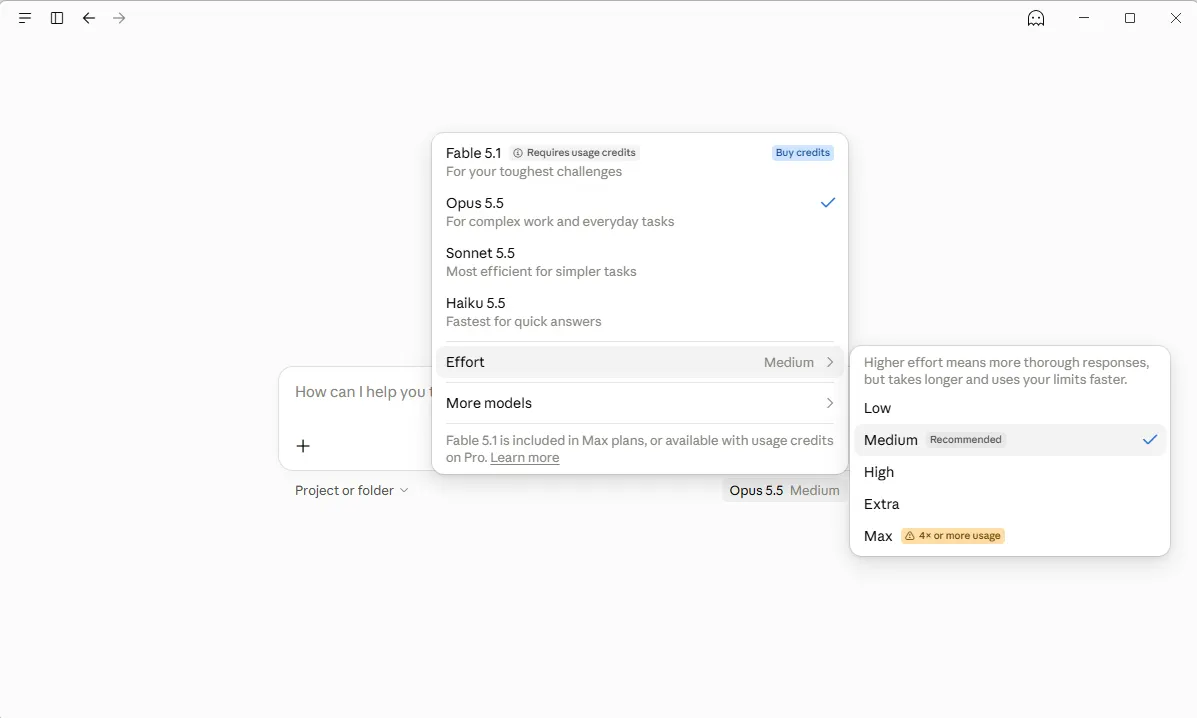
Führe fünf der Aufgaben der letzten Woche mit beiden Modellen parallel aus, und wenn das kleine besteht, behalte es. Bei einem Abonnement verlängert das dein Nutzungslimit, und bei der API senkt es die Rechnung um bis zu 99 %.
2. Schreibe einen guten Prompt statt fünf schlechter
Drei Runden von „nein, nur die Summe“ oder „mach das besser und genauer“ senden jedes Mal den gesamten Chat erneut. Ein klarer Prompt legt die Aufgabe und die genaue Form der Antwort fest. So etwas könnte funktionieren:
Extrahiere die Rechnungsnummer, das Datum, den Anbieter und den Gesamtbetrag aus dem untenstehenden Text. Behalte jeden Wert genau so bei, wie er geschrieben ist. Gib eine Zeile pro Feld zurück, und schreibe „fehlt“, wenn ein Feld nicht vorhanden ist.
OpenAIs eigene Tests ergaben, dass schlankere, klarere Prompts höher bewertet wurden, während sie weniger Tokens verbrauchten.
3. Starten Sie einen neuen Chat, wenn Sie das Thema wechseln
Das Modell liest die gesamte Konversation jedes Mal neu, wenn Sie auf Senden drücken, sodass ein 50-Nachrichten-Thread über Ihren Urlaub Ihre Steuerfrage gleichzeitig teurer und dümmer macht.
Anthropic nennt diesen Verfall "context rot."
Also, um Gottes willen, starten Sie einen neuen Chat, wann immer sich das Thema ändert.
4. Fragen Sie nach der Größe, die Sie brauchen
Ausgabe-Tokens kosten bei den Top-Modellen von Anthropic und OpenAI fünfmal mehr als Eingabe-Tokens. Beenden Sie Ihre Prompts mit etwas wie "drei Aufzählungspunkte, unter 100 Wörtern" oder "nur die geänderten Zeilen", und das Modell hat weniger Spielraum zum Auffüllen.
Wenn das Modell eine Einschränkung hinsichtlich der Ausgabelänge hat, wird es Tokens sparen, besonders wenn die Aufgabe kreativ ist (wie Schreiben oder Recherchieren) und nicht deterministisch (wie Programmieren oder Mathematik lösen).
5. Testen Sie kostenlos, bevor Sie zahlen
OpenRouter, eine Website, die über ein einziges Konto eine Verbindung zu Hunderten von KI-Modellen herstellt, hat einen kostenlosen Router, der Ihre Anfrage an eines von etwa 20 kostenlosen Modellen weiterleitet. Sie können Modelle auch lokal ausführen mit LM Studio oder Ollama auf einer Grafikkarte mit 8 GB Videospeicher oder einem Apple M-Serie-Mac.
Kostenlose Tarife können über Nacht verschwinden, also bauen Sie nichts Wichtiges darauf auf, und lesen Sie die Datenrichtlinie, bevor Sie etwas Sensibles einfügen.
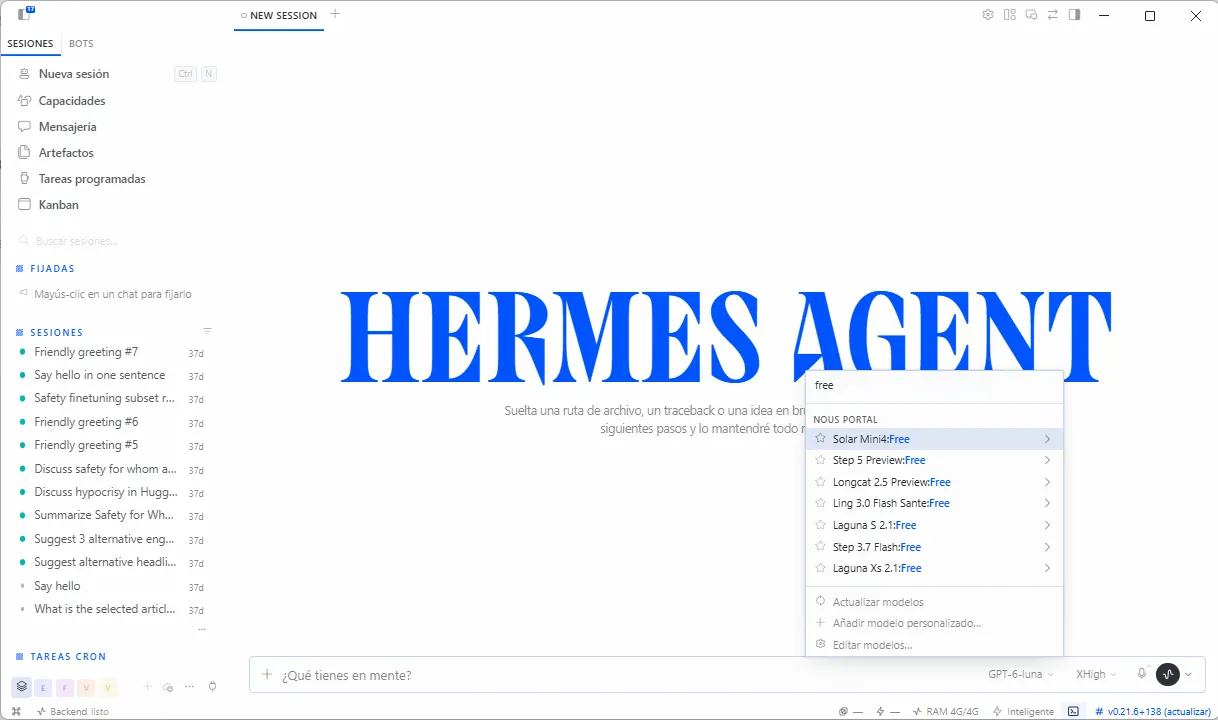
Allerdings können Sie Ihre Iterationen maximieren, indem Sie kostenlose Angebote nutzen. Hermes hat eine gute Auswahl an kostenlosen Modellen, die die Aufgabe erledigen könnten, die Sie brauchen, und Nvidia ebenfalls. Es ist besser, einen Prompt mit einem kostenlosen, dümmeren Modell anzupassen, als für ein Premium-Modell zu zahlen, das dasselbe tut, aber schneller.
Zusätzliche Tipps für Anfänger
Überspringe ausgedehntes Denken bei einfachen Fragen oder senke die Aufwandsstufe bei neueren Claude-Modellen, bei denen das Denken nicht abgeschaltet werden kann. Anthropic berechnet den gesamten Denkprozess als Ausgabe, einschließlich des Teils, den du nie siehst.
Abonnenten von Claude Pro und Max, die Nutzungsguthaben aktivieren, können unter Einstellungen und dann Nutzung ein monatliches Ausgabenlimit festlegen.
Fortgeschritten: Dein Agent liest viel zu viel
Ab hier verwenden die Beispiele Claude Code, Anthropics Agenten, der in deinem Terminal läuft und Dateien für dich bearbeitet; Befehle gehen direkt in dessen Chat-Feld. Andere Harnesses werden eine ähnliche Logik haben.
Wenn du nur die Chat-Apps verwendest, funktioniert Tipp 8 auch in jedem Chat-Fenster.
6. Günstig anfangen, bei Fehlschlag eskalieren
Tippe /model, um Modelle zu wechseln, behalte Sonnet als Standard und wechsle erst zu Opus, wenn Sonnet bei etwas Bestimmtem scheitert, etwa einem Bug, den es nach zwei Versuchen nicht beheben kann. Für einfache Subagenten-Aufgaben empfehlen Anthropics Dokumente, model: haiku in den Einstellungen des Subagenten festzulegen.
7. Zwischen Aufgaben aufräumen
Tippe /clear, wenn du zu einer unabhängigen Aufgabe wechselst, was nichts kostet und den alten Verlauf verwirft. Verwende /compact mit einer Notiz darüber, was beibehalten werden soll, wie /compact behalte die Datenbankentscheidungen, nur wenn du den Verlauf brauchst, da das Komprimieren selbst eine große Anfrage ist.
8. Lass den Code die langweilige Mathematik machen
Eine Tabelle mit 5.000 Zeilen in einen Chat einzufügen, bringt das Modell dazu, jede Zeile zu lesen, und es kann sich trotzdem verzählen, denn ein Sprachmodell ist kein Taschenrechner, egal wie viel du dafür bezahlst.
Bitte es stattdessen um eine Formel oder ein kurzes Skript, führe das selbst aus und gib dem Modell nur das Ergebnis.
9. Reduziere deine Werkzeuge
MCP-Server sind Plugins, die ein Modell mit Apps wie GitHub oder Google Drive verbinden, und jeder einzelne fügt jeder Sitzung Werkzeugnamen und Anweisungen hinzu.
Tippe /context, um zu sehen, was Platz verbraucht, und /mcp, um Server zu deaktivieren, die das Projekt nicht nutzt.
Zusätzliche fortgeschrittene Tipps
Tippe /usage, um zu sehen, wohin deine Tokens gegangen sind. Halte deine CLAUDE.md (oder Soul.md), die Anweisungsdatei, die dein Agent zu Beginn jeder Sitzung liest, unter 200 Zeilen.
Drücke bei größeren Änderungen Shift+Tab, um in den Planungsmodus zu wechseln, in dem der Agent einen Plan zur Genehmigung vorschlägt, bevor er Dateien anfasst, und drücke Esc, sobald er in die falsche Richtung läuft. Verwende /effort, um das Reasoning für einfache Aufgaben wie das Umbenennen einer Variable herunterzufahren.
Anthropic zeigte, dass der Token-Verbrauch eines Agenten von 150.000 Tokens auf 2.000 sank, als er nur die Werkzeugdefinitionen lud, die er brauchte, sodass Kommandozeilenwerkzeuge wie GitHubs gh, die nichts kosten, bis sie ausgeführt werden, oft ein immer aktives Plugin schlagen.
Fortgeschritten: Baue die Schutzgeländer ins System ein
Nimm einen Entwickler, der 1.000 Rechnungen mit je 2.000 Tokens verarbeiten muss, mit Antworten von 200 Tokens: Die Aufgabe kostet etwa 30 $ auf Fable 5.1 und etwa 0,30 $ auf Haiku 5.5, noch vor all den Tricks unten.
10. Cache die Teile, die sich nie ändern
Setze die stabilen Anweisungen an den Anfang und die sich ändernden Teile ans Ende, und markiere den stabilen Block für das Caching. In der API von Anthropic ist das ein zusätzliches Feld:
"system": [{
"type": "text",
"text": "Deine Rechnungsanweisungen...",
"cache_control": {"type": "ephemeral"}
}]
Das Lesen aus dem Cache kostet einen Bruchteil des normalen Eingabepreises, während das Schreiben in den standardmäßigen Fünf-Minuten-Cache zusätzliche Kosten verursacht. Prüfe das Feld cache_read_input_tokens in jeder Antwort; wenn es nach dem ersten Aufruf immer noch null anzeigt, funktioniert der Cache nicht.
11. Fasse alles in Batches zusammen, was warten kann
Sowohl OpenAI als auch Anthropic verarbeiten Batch-Jobs mit 50 % Rabatt, wobei OpenAI Ergebnisse innerhalb von 24 Stunden verspricht. Lade die 1.000 Rechnungen als eine einzige Batch-Datei hoch, anstatt 1.000 Live-Aufrufe zu machen, und die Rechnung sinkt stark.
12. Halte Agenten an der Leine
Lege eine maximale Anzahl von Schritten und eine Dollar-Obergrenze für jeden Agentenlauf fest und definiere, wie "fertig" aussieht, bevor er beginnt. Claude Code akzeptiert ein --max-budget-usd-Flag für skriptgesteuerte Läufe, und Shopify verwendet Circuit Breaker, die den Zugriff eines Entwicklers sofort abschneiden können, wenn seine Ausgaben innerhalb eines Tages in die Höhe schnellen, entwickelt, um durchgehende Agenten abzufangen.
Im Moment ist das Übliche, diese Agenten tatsächlich freizusetzen und sie schleifen zu lassen, bis das Ergebnis als perfekt erachtet wird. Wenn du das Geld nicht hast, lass deine Agenten nicht einfach entscheiden, was "perfekt" ist und was nicht.
Zusätzliche fortgeschrittene Tipps
Setze entscheidende Fakten an den Anfang oder das Ende eines langen Prompts. Eine von Stanford geleitete Studie fand heraus, dass Modelle Informationen an diesen Positionen am besten nutzen und am schlechtesten, wenn sie in der Mitte vergraben sind.
Bezahle für ein zweites Modell, das die Arbeit prüft, nur wenn ein Fehler teuer ist, etwa bei einer Vertragsklausel oder einem Zahlungsbetrag. Aktiviere in der API von OpenAI ein hartes Ausgabenlimit für jedes Projekt, da seine Ausgabenwarnungen dich nur benachrichtigen und den Verkehr nicht stoppen.
Beginnen Sie mit einem Test
Machen Sie das günstigste Modell, das Ihren Fünf-Aufgaben-Test aus Tipp 1 besteht, für eine Woche zu Ihrem Standardmodell, und wechseln Sie nur dann, wenn es versagt. Vergleichen Sie dann Ihre Nutzungsseite mit der der Vorwoche; bei der Rechnungsaufgabe senkte allein das Routing die Rechnung von 30 $ auf 3,90 $, selbst nachdem Opus 5.5 dafür bezahlt wurde, 300 Fehler zu wiederholen.
Günstigere Tokens allein erledigen die Arbeit jedoch nicht: Der Preis eines einzelnen Tokens ist laut dem Token Expenditure Index von Silicon Data seit 2023 um mehr als 90 % gefallen, doch die Ausgaben für große Sprachmodelle haben sich seit Ende 2025 verdoppelt.
Ökonomen nennen das das Jevons-Paradoxon: Wenn eine Ressource so billig wird, dass die Menschen insgesamt mehr dafür ausgeben. Ein Brief von Bain & Co. vom Juni fand dasselbe Muster: Die Token-Kosten halbierten sich zwischen Dezember 2024 und 2025, während die Zahl der verbrauchten Tokens um 450 % wuchs.
Der Vorteil ist, dass dieselben fallenden Preise für Sie wirken, sobald Sie aufhören, Tokens zum Vergnügen zu verbrennen: Kombinieren Sie sie mit den oben genannten Gewohnheiten, und KI wird gleichzeitig günstiger und besser.