简而言之
- Anthropic 和 OpenAI 的顶级模型每 token 的成本比它们最小的模型高出 100 倍,但许多用户却默认对所有任务都使用旗舰模型。
- Meta、亚马逊和 Uber 的使用排行榜推高了 AI 账单,Uber 在大约四个月内就烧完了其 2026 年 AI 工具预算。
- 将任务路由到合适的模型、精简上下文、缓存和批处理能大幅降低成本,但还有其他节省费用的技巧。
今年早些时候,Meta 员工在 30 天内消耗了 60 万亿个 AI token,只为在一个被戏称为“Claudeonomics”的内部排行榜上争夺名次。科技专栏作家 Gergely Orosz 估算这笔费用按 Anthropic 的标价约为 9 亿美元,不过 Meta 实际支付的费用可能远低于此。
贝恩公司(Bain & Company)顾问 Jue Wang 在各处都看到了这种浪费的温和版本:“这么多公司、这么多用户,默认对所有事情都使用 Opus,包括生成电子邮件,”她今年夏天告诉美联社,指的是 Anthropic 的高端模型。如果你也这样做,那你就是在雇阿尔伯特·爱因斯坦来算你在麦当劳找零多少钱。
你输入 ChatGPT 或 Claude 的每一个词,以及它回写的每一个词,都以 token 计量,即平均约为四分之三个词大小的文本块。在 20 美元的订阅中,这个计量器决定了你多快达到使用上限。在 API 上——开发者用来将模型接入自己应用的按 token 付费访问方式——它决定了账单。
以下是 Anthropic 当前的价目表,按每百万 token 计:
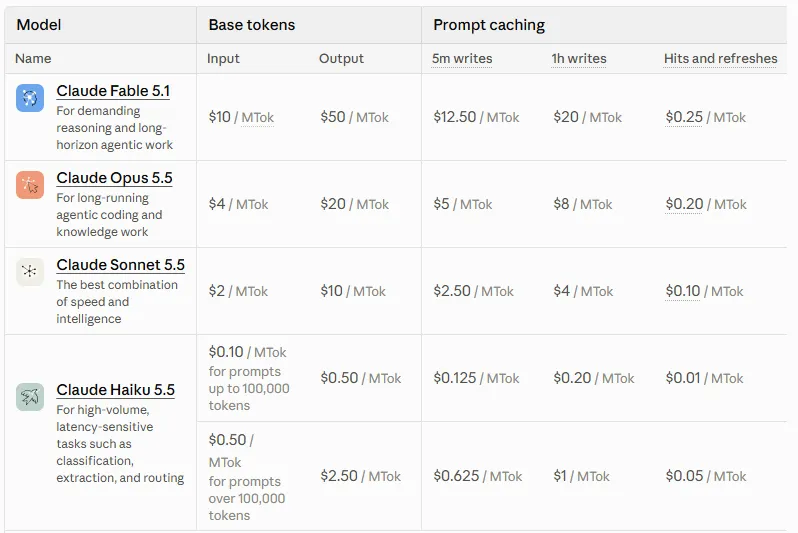
Haiku 的费率适用于低于 100,000 个 token 的提示词;更长的提示词费用是五倍。
顶级模型的费用是最小模型的一百倍,而 OpenAI 的自家产品线也呈现同样的跨度,从每百万输入 token 10 美元到 0.10 美元不等。这些按 token 计的价格对实验室——以及你——来说会迅速累积:Anthropic 的收入年化运行率从 2025 年底的约 90 亿美元增长到 5 月的超过 470 亿美元,而 OpenAI 则在打一场价格战以跟上步伐。
几个习惯就能大幅削减这笔开支,而下面的前五个技巧无需任何编程。
tokenmaxxing 意味着什么(以及它应该意味着什么)
tokenmaxxing 最初是硅谷的一种炫耀方式,就像 Meta 的 Claudeonomics 一样,微软、Shopify 和亚马逊都根据类似的 token 排行榜给员工排名。英伟达 CEO 黄仁勋在 3 月的“All-In”播客上火上浇油,他说如果一位年薪 50 万美元的工程师没有烧掉至少价值 25 万美元的 token,他会“深感震惊”。
而他们确实烧掉了 token……用在愚蠢且毫无产出的东西上。
在亚马逊,员工承认虚增了他们的数字,方法是让内部 AI 工具运行无关任务,直到一位高级副总裁告诉员工:“请不要仅仅为了用 AI 而用 AI。”
本指南采用工程师们现在推崇的含义:最大化每个 token 的价值,而不是你花费的数量。
三个概念解释了 token 都去了哪里,首先是智能体循环。智能体是一个可以使用工具的模型,因此它会思考、搜索网络或运行代码、读取结果,然后再次行动,直到它决定完成为止,每一轮都会重新发送整个对话。
编排会成倍放大这一成本:一个模型充当管理者,将你的请求拆分成若干部分,交给称为子智能体的工作模型,再把它们的答案拼接回去。每个工作者都用自己的记忆运行自己的循环,这就是为什么 Anthropic 表示,当队友在计划模式下运行时,Claude Code 中的智能体团队使用的 token 数量可能比标准会话多出约七倍,该设置将在下面的中级技巧中介绍。
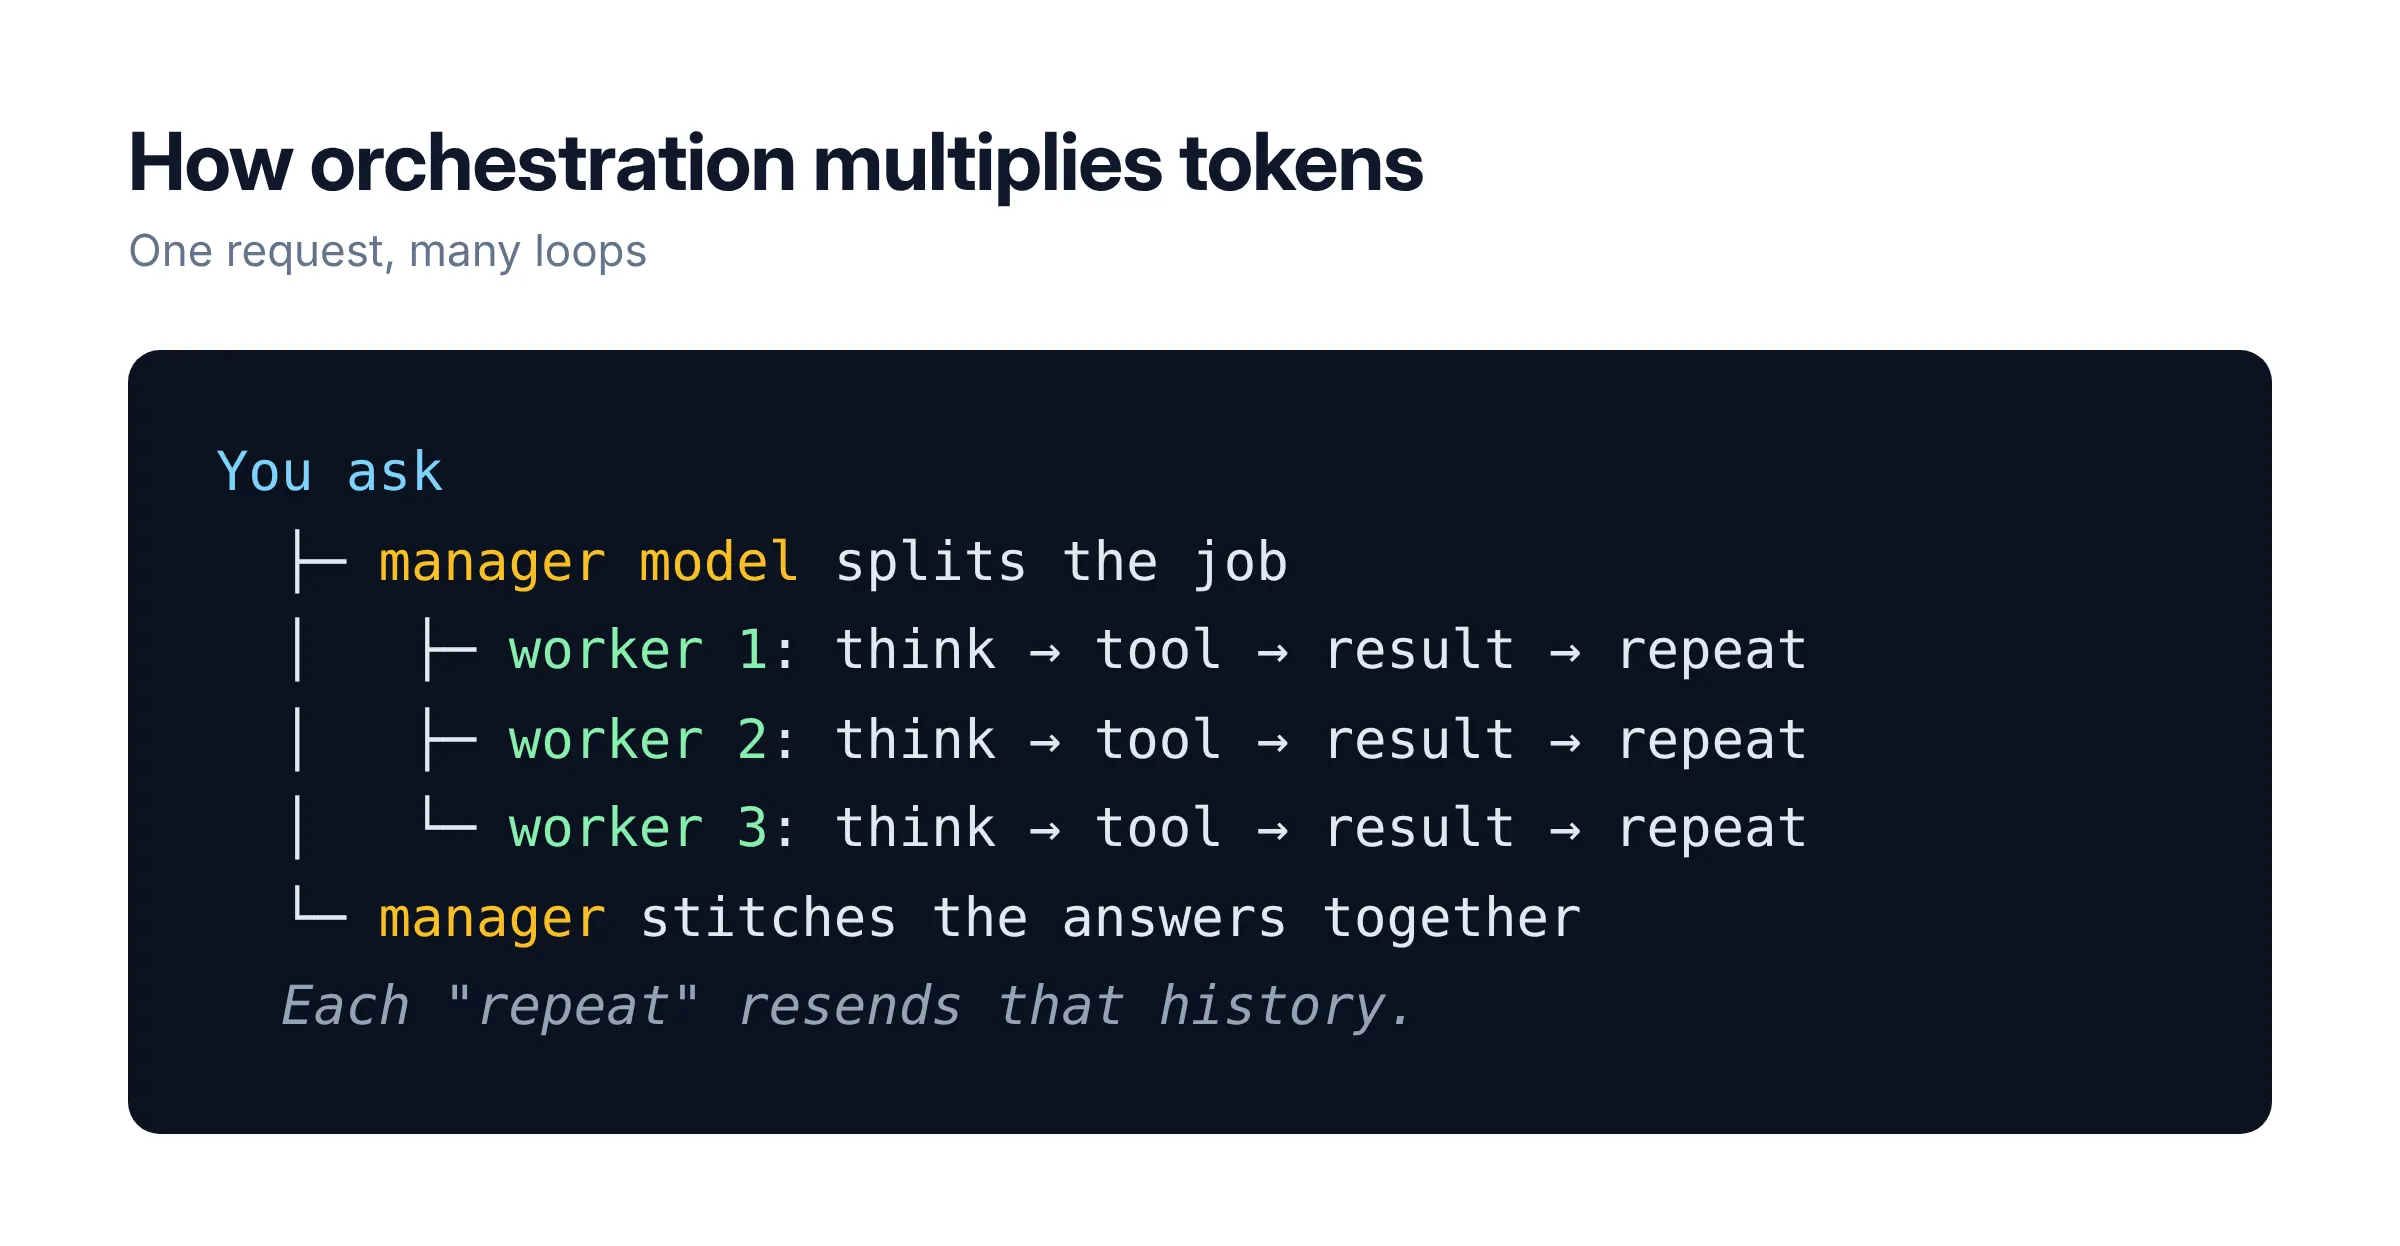
图是开发者防止这些循环跑偏的方式。像LangGraph这样的框架让你像画地铁图一样绘制工作流,车站(节点)负责执行工作,轨道(边)决定下一步去哪里,因此模型会沿着固定路线前进,而不是一直循环到没有想法或预算为止。
换句话说,循环能帮助你实现自动化并提升质量,但你也会花很多钱,因此保持高效极其重要。以下是一些可能对你有帮助的技巧
入门:小任务,小模型
1. 为任务挑选合适的模型
如果你刚刚起步,你很可能正在使用图形用户界面来运行你的 AI。
在你的聊天应用中点击模型名称(在 ChatGPT 中位于聊天窗口顶部,在 Claude 或 Hermes 中位于发送按钮旁边),切换到更小、更快的选项,用于处理电子邮件、摘要和改写。把顶级模型留给需要艰难推理和决策的场景,因为在这些场景中,一个细微的错误就会造成实实在在的金钱损失。
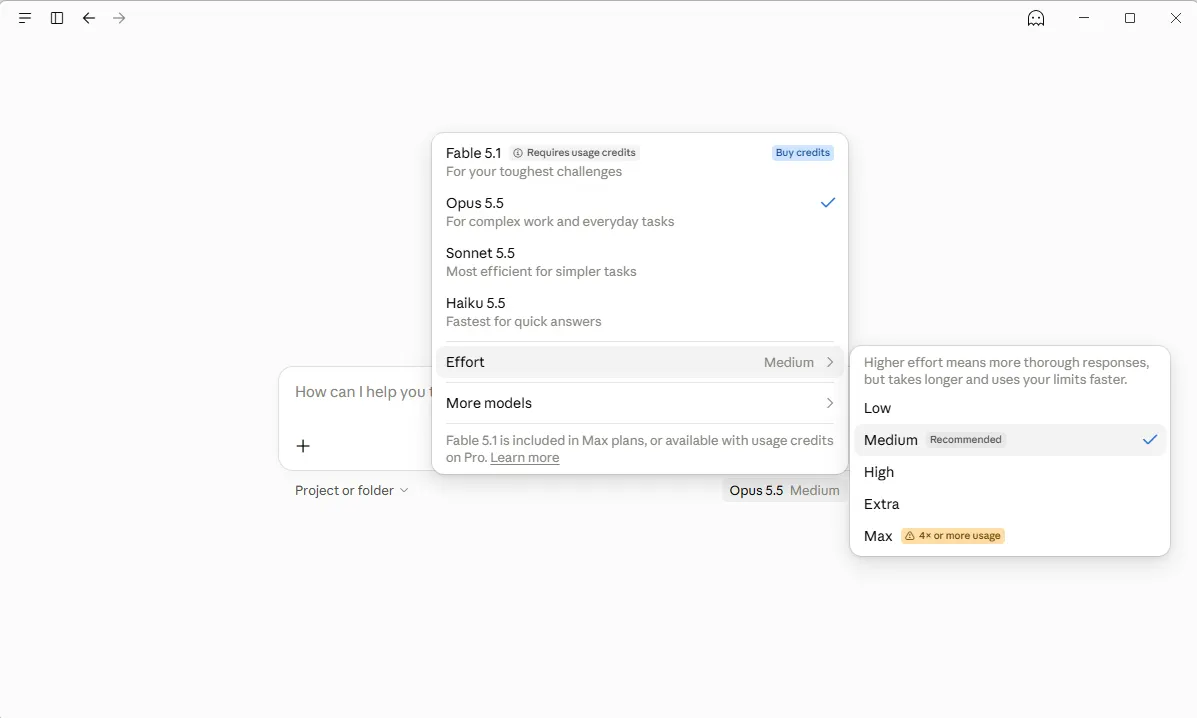
把上周的五个任务在两个模型上并排运行,如果小模型能通过,就继续用它。在会撑爆你用量上限的订阅套餐上,以及在 API 上,这最多能把账单削减 99%。
2. 写一条好的提示词,而不是五条糟糕的提示词
三轮“不,只要总数”或“把这个改得更好、更准确”每次都会把整个对话重新发送一遍。一条清晰的提示词会明确说明任务以及答案的确切形式。类似下面这样的写法可能就行得通:
从下面的文本中提取发票号码、日期、供应商和总额。每个值都完全按照原文保留。每个字段返回一行,如果某个字段不存在,就写“缺失”。
OpenAI 自己的测试发现,更精简、更清晰的提示词得分更高,同时使用的 token 更少。
3. 当你更换话题时,开启一个新对话
每次你点击发送时,模型都会重新阅读整个对话,所以一段关于你假期的 50 条消息的对话,会让你的税务问题同时变得更贵、更笨。
Anthropic 将这种衰减称为“上下文腐化(context rot)”。
所以,看在上帝的份上,只要主题一变,就开启一个新对话。
4. 要求你需要的篇幅
在 Anthropic 和 OpenAI 的顶级模型上,输出 token 的成本是输入的 5 倍。在你的提示词末尾加上类似“三个要点,100 词以内”或“只给出改动的行”这样的要求,模型就没有多少空间来注水了。
如果模型在输出长度方面受到约束,它就会节省 token,尤其是当任务属于创造性任务(比如写作或研究)而非确定性任务(比如编程或解数学题)时。
5. 付费之前先试用免费版
OpenRouter 是一个通过一个账户连接数百个 AI 模型的网站,它有一个免费路由器,会把你的请求发送到大约 20 个免费模型之一。你也可以在拥有 8GB 显存的显卡或 Apple M 系列 Mac 上,用 LM Studio 或 Ollama 在本地运行模型。
免费套餐可能会一夜之间消失,所以不要在上面构建任何重要的东西,并且在粘贴任何敏感内容之前先阅读数据政策。
话虽如此,你可以通过使用免费额度来最大化你的迭代次数。Hermes 有一批不错的免费模型,可能能完成你需要的任务,Nvidia 也是如此。用一个免费的、更笨的模型来调整提示词,比花钱用一个高级模型来做同样的事情(只是更快)要好。
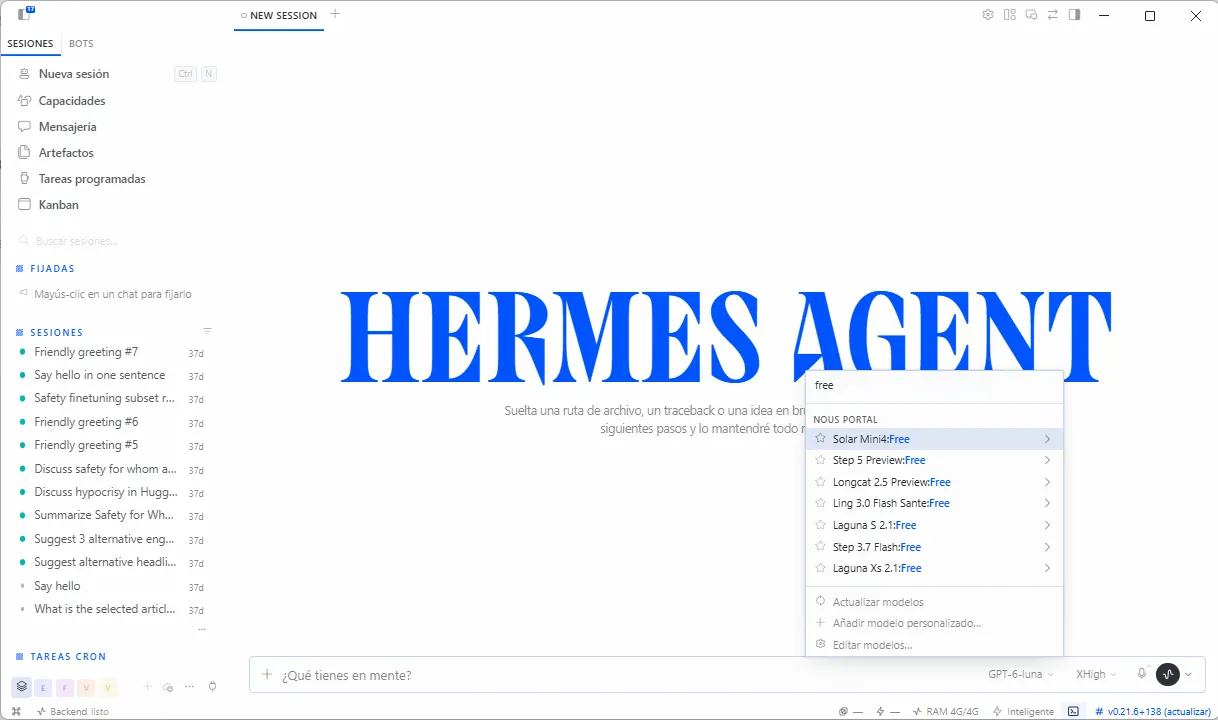
更多初学者提示
对于简单问题,跳过扩展思考;或者在无法关闭思考功能的较新 Claude 模型上,降低努力程度设置。Anthropic 会将完整的思考过程作为输出计费,包括你从未看到的部分。
开启使用额度的 Claude Pro 和 Max 订阅用户,可以在“设置”下的“用量”中设置每月支出上限。
中级:你的智能体读取的内容太多了
从这里开始,示例使用 Claude Code,这是 Anthropic 的智能体,在你的终端中运行并为你编辑文件;命令直接输入到它的聊天框中。其他运行框架也会有类似的逻辑。
如果你只使用聊天应用,第 8 条提示在任何聊天窗口中同样适用。
6. 从低成本开始,失败后再升级
输入 /model 切换模型,将 Sonnet 保持为默认模型,只有当 Sonnet 在某个具体任务上失败时才升级到 Opus,比如一个它尝试两次仍无法修复的 bug。对于简单的子智能体任务,Anthropic 的文档建议在子智能体的设置中设置 model: haiku。
7. 在任务之间清空上下文
当你切换到不相关的任务时,输入 /clear,这不会产生任何费用,并会丢弃旧的历史记录。只有在需要历史记录时,才使用 /compact 并附上要保留内容的说明,例如 /compact keep the database decisions,因为压缩本身就是一个大型请求。
8. 让代码来做枯燥的计算
把一份 5,000 行的电子表格粘贴到聊天中,会让模型读取每一行,而且它仍然可能数错,因为无论你花多少钱,语言模型都不是计算器。
相反,向它索要一个公式或一段简短的脚本,你自己运行它,然后只把结果交给模型。
9. 精简你的工具
MCP 服务器是插件,用于将模型连接到 GitHub 或 Google Drive 等应用,每一个都会向每个会话添加工具名称和指令。
输入 /context 查看是什么在占用空间,输入 /mcp 禁用项目未使用的服务器。
其他中级技巧
输入 /usage 查看你的 token 都花在哪里了。将你的 CLAUDE.md(或 Soul.md)——即你的智能体在每个会话开始时读取的指令文件——保持在 200 行以内。
对于较大的更改,按 Shift+Tab 切换到计划模式,在该模式下,智能体会在改动文件之前提出一个计划供你批准,一旦它走错方向就立刻按 Esc。使用 /effort 为诸如重命名变量之类的简单任务降低推理强度。
Anthropic 展示了一个智能体在只加载它所需的工具定义时,token 使用量从 150,000 个 token 降至 2,000 个,因此像 GitHub 的 gh 这样在运行前不产生任何费用的命令行工具,往往胜过常驻的插件。
进阶:将防护措施内建到系统中
假设一位开发者需要处理 1,000 张发票,每张 2,000 个 token,答案为 200 个 token:在应用下面任何技巧之前,这项任务在 Fable 5.1 上花费约 30 美元,在 Haiku 5.5 上花费约 0.30 美元。
10. 缓存那些永不改变的部分
把稳定的指令放在前面,把变化的部分放在最后,并标记稳定块以便缓存。在 Anthropic 的 API 中,这只需额外一个字段:
"system": [{
"type": "text",
"text": "你的发票指令……",
"cache_control": {"type": "ephemeral"}
}]
从缓存读取的费用仅为正常输入价格的一小部分,而写入默认的五分钟缓存则需要额外付费。检查每次响应中的 cache_read_input_tokens 字段;如果第一次调用后它仍然显示为零,说明缓存没有生效。
11. 将任何可以等待的任务批处理
OpenAI 和 Anthropic 都以 50% 的折扣处理批处理任务,OpenAI 承诺在 24 小时内返回结果。将 1,000 张发票作为一个批处理文件上传,而不是进行 1,000 次实时调用,账单就会大幅下降。
12. 给智能体拴上绳子
为每次智能体运行设置最大步数和美元上限,并在开始前定义好“完成”是什么样子。Claude Code 接受 --max-budget-usd 标志用于脚本化运行,而 Shopify 使用熔断机制,如果开发者的支出在一天内激增,可以立即切断其访问权限,专门用于捕获失控的智能体。
目前,通常的做法是真正让这些智能体自由运行,让它们循环直到结果被认为完美为止。如果你没有钱,就不要让智能体自己决定什么算“完美”。
更多高级技巧
将关键事实放在长提示的开头或结尾。一项斯坦福大学主导的研究发现,模型在这些位置对信息的利用效果最好,而当信息被埋没在中间时效果最差。
只有在错误代价高昂时(例如合同条款或付款金额),才付费让第二个模型来检查工作。在 OpenAI 的 API 上,为每个项目开启硬性支出限额,因为其支出警报只会通知你,并不会停止流量。
从一个测试开始
把通过提示 1 中五项任务测试的最便宜模型设为你的默认模型,用一周,只在它失败时才切换。然后把你的用量页面与前一周的对比;在发票任务上,仅靠路由就把账单从 30 美元降到 3.90 美元,即使付钱给 Opus 5.5 重做了 300 次失败也不例外。
不过,更便宜的 token 本身并不能解决问题:根据 Silicon Data 的 Token 支出指数,自 2023 年以来单个 token 的价格已下降超过 90%,但自 2025 年末以来,大型语言模型上的支出却翻了一番。
经济学家称之为杰文斯悖论,即一种资源变得如此便宜,以至于人们最终在它上面花的总钱反而更多。贝恩公司 6 月的一份简报发现了同样的模式:2024 年 12 月至 2025 年间 token 成本减半,而消耗的 token 数量增长了 450%。
好的一面是,一旦你不再为了好玩而烧 token,同样的价格下降就会对你有利:把它们与上述习惯结合起来,AI 就会同时变得更便宜、更好用。